Una skill para que tu agente sepa si clonó bien un PDF
Equipo Easybits
6 min de lectura
skills
Cuando un agente convierte un PDF en HTML, el único juez suele ser él mismo o una persona que mira las dos páginas y dice «se ve bien». Ninguno de los dos escala: el agente se aprueba solo y la persona se cansa en la tercera página.
Hoy publicamos easybits-clone-verify, una skill que le da al agente un juez externo. Compara el clon contra el PDF original, página por página, y regresa un veredicto que no cambia entre corridas, con la lista de lo que está mal y en qué coordenadas. El agente arregla eso y vuelve a medir hasta que la página pasa.
De dónde sale la idea
Steve Sewell, de Builder.io, contó hace poco cómo llevó las importaciones de Figma y de Google Slides en su proyecto open source de un 20–88 % de diferencia a menos de 2 %: dejó a un agente trabajando un fin de semana contra un número fijo en lugar de revisar él cada resultado. El número era un diff de píxeles, una imagen que pinta en rojo cada punto que no coincide entre el original y la copia.
Lo interesante del planteamiento es el reparto de trabajo: el agente escribe código y la persona diseña el verificador. Con un verificador bueno, el agente puede iterar horas sin supervisión.
El problema de medir sólo píxeles
Nuestra primera versión hacía eso: pixelmatch sobre el original y la copia, más una revisión del texto del HTML. Antes de anunciarla le pusimos un agente con una sola instrucción: haz que pase sin clonar de verdad. Encontró 13 formas de lograrlo. Las más simples:
- Pegar el PDF como imagen y esconder el texto correcto debajo. En píxeles es idéntico y el texto «existe».
- Mostrar una cosa en pantalla y otra al imprimir, con
@media print. - Una fuente con los glifos cambiados: el HTML dice «7» y se dibuja «9».
- Un recuadro del color del fondo encima de una palabra.
Un agente que optimiza un número va a encontrar estos atajos, aunque nadie se lo pida. Por eso la versión que publicamos mide lo que el navegador pinta, nunca el código fuente.
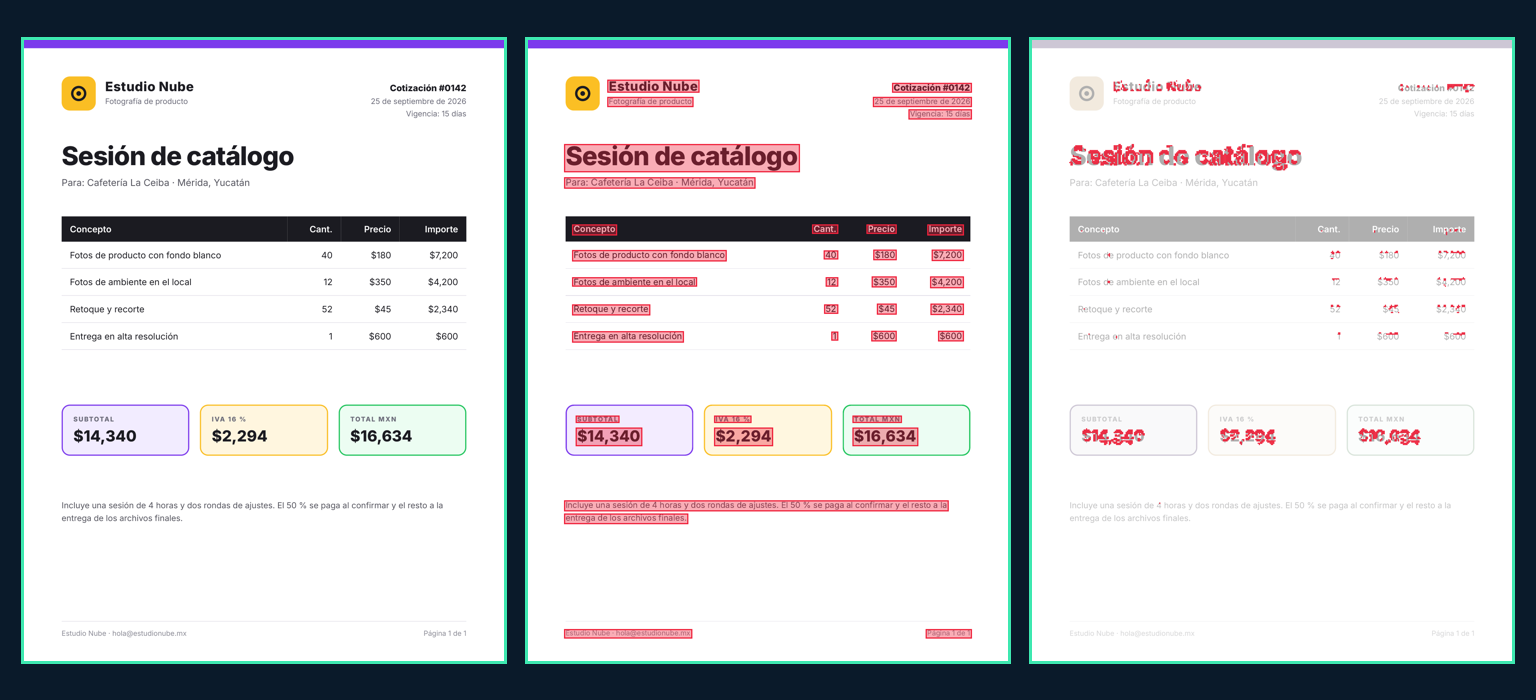
Qué mide
El clon se imprime a PDF dos veces, sin JavaScript, y se captura una vez en pantalla. El original, el clon y el clon sin su texto pasan por el mismo motor de rasterizado (MuPDF), así que un clon fiel da diferencia cero y cualquier desviación es real.
Texto, carácter por carácter. Cada palabra del PDF tiene que existir como texto del DOM, escrita en el HTML y a menos de 1.5 pt de su lugar. No puede faltar ninguna ni sobrar ninguna. La posición sale del origen y la línea base de cada carácter, que no dependen de cómo se incrustó la fuente.
Tipografía. Misma familia, tamaño, color y ancho de palabra. El peso y la cursiva se leen del descriptor de la fuente dentro del PDF, porque el nombre engaña: Chrome nombra todos los pesos de una fuente variable como «Inter-Regular». El ancho atrapa el espaciado de letras que usan las exportaciones de Word; sin él, los números de una tabla chocan con la columna siguiente.
Texto vivo. Si al quitar el texto del PDF impreso la zona de una línea sigue viéndose como ese texto, lo que hay ahí es una imagen. Funciona aunque la imagen esté corrida o difuminada unos píxeles.
Visibilidad y forma. Cada palabra tiene que verse (no tapada) y dibujarse con los glifos del original, comparados carácter contra carácter.
Composición. Fondos, colores, tablas y logos, medidos en promedio y en la zona pequeña más distinta. En una página casi blanca, borrar un logo de 60 px apenas mueve el promedio; la zona lo delata.
Pantalla igual a impresión. El texto sale de la impresión, así que lo que se ve en pantalla tiene que ser lo mismo.
Los umbrales son fijos. Quien llama suele ser el mismo agente al que se califica, y si pudiera pasar umbrales en cero todo aprobaría.
Cómo lo probamos
Armamos una batería que genera, desde cualquier PDF, un clon fiel y unas 25 variantes tramposas, y exige que cada una salga clasificada bien y por el motivo correcto. En tres PDFs muy distintos (una exportación de Word con tablas, un documento de Google Docs en Arial y un reporte generado por Chrome con Inter variable) quedó 81 de 81. Las 22 trampas del agente atacante fallan todas, y en producción los veredictos coinciden con los locales.
La batería también nos corrigió a nosotros varias veces: el diff fino pintaba en rojo el suavizado de las letras en clones correctos, el MuPDF de Debian perdía los nombres de las fuentes en silencio, y la normalización Unicode aceptaba «m2» donde el original dice «m²».
El lazo del agente
La skill le enseña al agente a trabajar así:
- Una página por archivo (
page-1.html,page-2.html…), diseñada al tamaño de la página del PDF: puntos × 4/3. Una carta mide 816 × 1056 px. - Medir:
node scripts/compare.mjs --pdf <fileId o URL> --dir ./clon. - Leer el primer motivo de la primera página que falla. Vienen en español, con la palabra y su posición: «1 palabra(s) existen pero no se ven (tapadas o invisibles): «Estudio» (138,87)».
- Arreglar y volver al paso 2, hasta que el comando salga en 0.
El HTML tiene que ser estático: nada de scripts, @media, backdrop-filter, mix-blend-mode ni hojas de estilo externas (Google Fonts sí). Una página de PDF no los necesita, y son justo lo que permitiría mostrar en pantalla algo distinto a lo impreso.
Sin la skill
La misma verificación está en la API, el SDK y el MCP:
En MCP la tool es compare_render, y los agentes de la flota la tienen siempre en su MCP render. Cuesta un crédito por página y acepta hasta 20 páginas por llamada.
Límites
El texto con degradado hecho con background-clip: text puede reprobar aunque el clon sea correcto. Y el verificador compara contra el PDF, así que si el PDF original usa una fuente de pago que no puedes cargar, la página no va a pasar hasta que la tengas: los umbrales no se relajan por llamada.
La skill está en easybits.cloud/skills y en github.com/blissito/easybits-skills. La referencia completa, en la documentación.

